Mostrando postagens com marcador geometria analítica. Mostrar todas as postagens

quinta-feira, 21 de maio de 2020

Quais os melhores livros de Álgebra Linear?


Um bom livro pode ser um divisor de águas na vida de qualquer pessoa. Um bom livro técnico certamente faz diferença na jornada de aprendizado de um estudante. Mas como não é fácil descobrir quais são esses títulos, decidi escrever esse artigo com minhas impressões e sugestões sobre quais os melhores livros de Álgebra Linear, assim como fiz no artigo anterior “Quais os melhores livros de Cálculo 1?” 

Em 2009, quando estudei Álgebra Linear, tive contato com vários títulos, de diversos autores. 10 anos depois, voltei a encará-los por conta do Mestrado, então aqui vão minhas impressões sobre o que acumulei de conhecimento sobre eles:


Álgebra Linear de Alfredo Steinbruch e Paulo Winterle

 Clique na capa para comprar na Amazon.com.br


É um livro básico, introdutório, bastante utilizado nos cursos de Engenharia pelo Brasil. Possui uma boa quantidade de exemplos e diagramas e cobre os temas principais da Álgebra Linear, mas não surpreende. 

Foi um livro indicado durante o meu curso de Álgebra Linear mas eu preferi utilizar outros títulos. Pelo preço que é cobrado, existem opções melhores para se adquirir. 

Onde o livro acerta:
  • É um livro balanceado em termos de conteúdo/exercícios
Onde o livro erra: 
  • Não apresenta nenhuma aplicação prática 
  • O conteúdo é apresentado de forma rígida e sem “personalidade”, o que pode afastar estudantes e leitores 

Álgebra Linear (Schaum) de Seymour Lipschutz e Marc Lipson

 Clique na capa para comprar na Amazon.com.br
  

Excelente livro para praticar a mecânica de resolução dos problemas de Álgebra Linear. Explicações concisas, corretas, suficientes para quem já tem uma experiência mínima com livros de matemática. Coleção de exercícios excelentes, com níveis variados de dificuldade, além dos mais de 600 resolvidos.

Quando estudei Álgebra Linear utilizava o Lipschutz principalmente para complementar os exercícios dos outros livros. Guardo o exemplar até hoje, pois o formato de exercícios resolvidos é ótimo para consultas. Boa escolha para quem cursa matemática e para complementar a bibliografia principal dos estudantes de Engenharia. 

Onde o livro acerta: 
  • É um livro direto ao ponto nas explicações e não deixa de apresentar demonstrações. 
  • Bom para matemáticos 
  • Excelente seleção de exercícios 
  • Apêndices sobre produtos multilineares, estruturas algébricas, entre outros, são ótimas adições e boas introduções a esses conceitos que normalmente não são abordados em outros livros 

Onde o livro erra: 
  • Poucas figuras e gráficos 
  • Nenhuma aplicação prática ou computacional

Álgebra Linear de José Luiz Boldrini, Sueli I. R. Costa, Vera Lúcia F. Ribeiro e Henry Wetzler

 Clique na capa para comprar na Amazon.com.br


Livro clássico escrito por professores da Unicamp e amplamente utilizado nesta Universidade. Apresenta bons exemplos e aprofunda temas aplicados como Cadeias de Markov, assim como no Anton. Deixa de lado a exposição de Matrizes no campo dos números complexos. 

Foi pioneiro a introduzir aplicações práticas intercalada nos capítulos, isso na década de 80, porém já sofre com o tempo pois não teve nenhuma reedição desde então. Portanto, não contextualiza a álgebra linear frente aos grandes progressos das últimas décadas, como expansão da internet, aplicação em modelos de machine learning, esquemas criptográficos modernos, etc. Mesmo assim, é um bom livro para utilizar como fonte para um primeiro curso de Álgebra Linear. 

Foi a fonte principal utilizada quando cursei Álgebra Linear. 

Onde o livro acerta: 
  • É um livro curto que apresenta os principais pontos da álgebra linear de maneira clara 
  • Alguns capítulos apresentam aplicações em diversas áreas das ciências aplicadas, como física e biologia  
Onde o livro erra: 
  • Conta com menos exercícios que os concorrentes 
  • Salvo engano, são quase 40 anos sem uma nova edição. Poderia receber uma atualização trazendo novos exemplos e exercícios, além da correção de alguns erros pontuais

Álgebra Linear com Aplicações de Howard Anton e Chris Rorres

 Clique na capa para comprar na Amazon.com.br


O livro de Álgebra Linear do Howard Anton está para a Álgebra Linear assim como o livro de Cálculo do Stewart está para o Cálculo: é uma introdução clássica (primeira edição 1973) e prática ao tema, orientada aos cursos universitários de exatas. O livro é bem diagramado, colorido, de páginas largas. O conteúdo conta com explicações extensas, diversos exemplos e uma boa bateria de exercícios em cada capítulo. Assim como no Stewart, Anton opta pela abordagem prática, não se preocupando com as demonstrações mas sim pelas consequências e aplicações. 

Conta com diversos exemplos práticos de aplicações, o que é raro em livros introdutórios e extremamente bem-vindo. Vale como o livro principal em cursos de engenharias mas não deve ser o único livro de estudantes de Matemática. 

Utilizei o livro do Anton como fonte sobre aplicações de Álgebra Linear na disciplina do Mestrado.

Onde o livro acerta: 
  • Capítulo dedicado a aplicações
  • Notas de rodapé com breves históricos dos matemáticos ajudam a contextualizar os tópicos 
  • Centenas de imagens e diagramas de ótima qualidade
Onde o livro erra: 
  • Não se aprofunda em demonstrações 
  • É um livro dos moldes dos livros técnicos universitários americanos, que não estimulam tanto o pensamento crítico
  • A tradução em português é ruim e há erros de tipografia

Álgebra linear e suas aplicações de Gilbert Strang

 Clique na capa para comprar na Amazon.com.br


O livro do Strang tem provavelmente menos exercícios que o Lipschutz e menos figuras do que Anton, mas dentre todos, é disparado o melhor livro de Álgebra Linear. Antes de ser um bom escritor, Strang é um excelente professor. A boa didática transpira a cada página deste volume. Os capítulos não seguem exatamente o mesmo padrão dos outros livros, pois Strang compreende que faz sentido estudar certos problemas primeiro para que facilitem o entendimento da estrutura fundamental dos espaços vetoriais, principal elemento da Álgebra Linear.

É um livro que tem uma prosa quase que de sala de aula, em que o professor conecta conceitos enquanto explica, antecipando alguns pontos e até fazendo algumas tangentes quando necessário. Os exemplos e exercícios são bons, há exercícios desafiadores e tópicos que vão além das ementas tradicionais, abordando com profundidade assuntos extremamente relevantes nas ciências aplicadas: processamento de imagens, análise de componentes principais, FFT, grafos e redes, entre outros. Strang nos convida para, além de aprender corretamente os conceitos da Álgebra Linear, pensar como matemáticos e enxergar a beleza por trás do que estudamos. 

É um livro recomendadíssimo para estudos e que vale muito a pena ter um exemplar físico na sua biblioteca pessoal. Tive pouco contato com a versão traduzida e ouvi dizer que não é tão boa. Então se puderem, peguem a versão em inglês. 

Vale dizer que Strang continua na ativa lecionando Álgebra Linear no MIT e recentemente gravou videos para o curso “A 2020 Vision of Linear Algebra”. 

Onde o livro acerta: 
  • Excelente rigor e didática nas explicações e na condução dos tópicos 
  • Exercícios com variados níveis de dificuldade 
  • Excelente abordagem das aplicações da álgebra linear, em profundidade 

Onde o livro erra: 
  • Não há erros num livro como este. É uma obra-prima. 

Menções honrosas


Álgebra Linear: Uma Introdução Moderna por David Poole: Não conheço o livro, mas pelo índice e pela formatação acredito que segue a linha do Anton, com bastante exemplos de aplicações práticas. Como foi editado em 2006, os exemplos já abordam assuntos contemporâneos, como SVD. Parece ser um bom livro para adotar como livro-texto principal, mas não sei dizer quanto à qualidade da tradução.

Linear Algebra Done Right por Sheldon Axler: É um livro para matemáticos e para uma segunda leitura. Assim como o Strang, Axler busca um ângulo diferente para ensinar, neste caso evitando a introdução de determinantes durante todo o desenvolvimento da teoria dos espaços vetoriais e transformações lineares. Vale a pena a leitura para trazer novas perspectivas sobre o assunto.

Finalizando


Todos os livros fornecem uma base teórica comum. No entanto, nem todos os textos conseguem ir além do básico, estimulando o pensamento matemático ou convidando o leitor a apreciar aplicações reais da Álgebra Linear. 

Para preencher a sua coleção de conhecimentos é preciso beber de muitas fontes - principalmente das melhores. Assim, ganha-se experiência e maturidade para enxergar conceitos de diferentes ângulos, facilitando cada vez mais a sua jornada de aprendizado. 

Leia bastante e estude bastante, sempre!

Obs: Os links do artigo levam para os anúncios dos livros citados no site da Amazon. Quando você compra um livro eu recebo uma pequena comissão, que me estimula a continuar escrevendo mais. Obrigado!

quarta-feira, 15 de agosto de 2012

O que é transformação linear?


Vamos iniciar a série sobre transformações lineares respondendo exatamente a pergunta "O que é uma transformação linear?"

Não pretendo seguir uma formalidade e nem mesmo gastar muito tempo revisando o texto. Eu diria que 50% do que escrevo vem da cabeça, de coisas que eu já estudei, e nos outros 50% sigo o livro do Hoffman de Álgebra Linear. Então se houver algum erro corrijam-me por favor.

Se você procurar nos livros a definição, é provável que encontre algo mais ou menos nessa linha como no livro do Hoffman:

Seja $V$ e $W$ espaços vetoriais sobre o corpo $F$. Uma transformação linear de $V$ em $W$ é uma função $T$ que leva vetores de $V$ em $W$ de tal forma que:

$T(v_1+v_2)=T(v_1)+T(v_2)$ e $T(av_1)=aT(v_1)$

para todo $v_1$ e $v_2$ em $V$ e todo $a \in F$.

Talvez seja essa a definição mais genérica possível, pois nem mesmo o corpo é explicitado. Em geral, o corpo dos números reais é o mais comumente utilizado, enquanto que na física, física matemática e certas aplicações de engenharia pode-se utilizar os corpo dos números complexos. Para saber mais sobre o que é um corpo, veja http://pt.wikipedia.org/wiki/Corpo_(matem%C3%A1tica).

Mas como traduzir essa formalidade para o terreno humano?

Veja então que uma transformação linear é necessariamente uma regra, isto é, uma função, que obedece as condições supracitadas, não necessariamente separadas. Pode-se ter da mesma forma uma transformação linear com a seguinte cara: $T(v_1+ a v_2) = T(v_1) + a T(v_2)$.

O fato da definição ser genérica pode dificultar nosso entendimento, mas vamos recorrer a alguns exemplos algébricos:

Seja $V$ e $W$ qualquer espaço vetorial. A transformação linear que leva um vetor nele mesmo é chamada transformação identidade e tem a seguinte forma: $Iv=v$ (a notação muitas vezes depende do autor, alguns usam parênteses, outros não... eu costumo utilizar quando quero dar alguma ênfase).
Há também a transformação nula, isto é, $0v=0$. Para verificar que são transformações lineares, basta verificar que:

  1. $I(v_1+v_2) = I(v_1)+I(v_2) = v_1 + v_2$, pois $I(v_1)=v_1$ e $I(v_2)=v_2$ por definição da transformação identidade. De mesmo modo, $I(av_1) = a I(v_1) = a v_1$.
  2. $0(v_1+v_2)=0(v_1)+0(v_2)=0+0=0$. De mesmo modo $0(a v_1)=a 0(v_1)= a 0=0$.

Repare também que pela definição qualquer transformação linear do elemento neutro 0 resulta necessariamente no próprio elemento neutro, ou seja: $T(0) = 0$, pois $T(0) = T(0+0) = T(0) + T(0)$. Se $T(0)=T(0)+T(0)$, ao subtrair $T(0)$ dos dois lados chega-se em $T(0)=0$.

Devido a essa última propriedade, que pode ser enunciada como "qualquer transformação linear leva necessariamente o zero ao zero", pode haver uma certa confusão entre as transformações lineares e as funções lineares. As funções lineares podem ser vistas como retas no plano, mas as únicas funções lineares (retas no plano) que são também transformações lineares (no sentido que estamos justamente explicando) são aquelas que passam pela origem, pois toda transformação linear deve obedecer $T(0)=0$.
Para entender melhor, imagine duas funções $f(x)=2x$ e $g(x)=2x+3$. De fato, para uma escolha genérica de $x_1$ e $x_2$ :

Da definição da função $f(x_1+x_2)=2(x_1+x_2)$, mas pela propriedade da transformação linear $f(x_1+x_2) = f(x_1) + f(x_2) = 2 x_1 + 2 x_2 = 2(x_1+x_2)$. Logo, $f(x)$ é, além de função linear, uma transformação linear, pois $f(0)=0$.

Agora repare que $g(x_1+x_2)=2(x_1+x_2)+3$, mas $g(x_1) + g(x_2) = 2x_1 + 2x_2 + 6 \neq g(x_1+x_2)$, logo, $g(x)$ não é transformação linear, embora seja uma função linear.

Saindo um pouco da álgebra, é interessante pensar nas transformações lineares em termos geométricos. Sugiro ao leitor que consulte algum livro de álgebra linear para verificar as transformações lineares no plano: contração, dilatação, rotação, reflexão, cisalhamento horizontal, cisalhamento vertical, etc... Na figura de uma manipulação que programei no Mathematica, seguem alguns exemplos. O quadro da esquerda é o vetor original, o quadro da direita o vetor transformado:


Este foi o primeiro post da série de álgebra linear. Fique ligado nos próximos. Se houver qualquer dúvida, envie um comentário.

Abraços


segunda-feira, 16 de julho de 2012

Pringles - Tutorial Mathematica Parte 2

Olá pessoal,

Depois de um bom tempo parado volto a postar neste nosso espaço. Pretendo escrever um pouco mais durante essas férias.

Como prometido, retomarei o primeiro post sobre como desenhar a batata Pringles no software Mathematica. Neste último mostrei como fiz para encontrar a equação e o domínio adequado para se chegar no formato da batata. Em suma, a partir da conhecida função sela generalizada ($z=a x^2- b y^2$, da qual variei os parâmetros $a$ e $b$) cheguei numa curva parecida com a da batatinha. Em seguida, tive que ajustar o domínio, pois toda vez que desenhamos alguma coisa no Mathematica, e em geral qualquer software de manipulação matemática, ele assume o domínio como sendo quadrado, o que não é o que eu desejava. Então para encontrar o domínio ideal tive que olhar a batata "por cima" e imaginar qual a melhor curva que se ajustava ao contorno observado. Pensei numa elipse e, da mesma maneira como a função de sela, fui variando os coeficientes e os expoentes da equação da elipse generalizada para obter um contorno satisfatório. Com o domínio e a curva definida, bastou combiná-los para obter uma boa aproximação da batatinha:


Agora, vamos ver como adicionar textura ao gráfico acima para que ele se torne uma batata. A nossa sorte é que ficou muito fácil manipular imagens e integrá-las aos objetos na última versão do Mathematica (8.0).

Para modificar o estilo de um gráfico, isto é, a maneira como ele vai ser desenhado, precisamos utilizar a instrução (directive em inglês) PlotStyle. Se não estou enganado todos os gráficos gerados pelo software aceitam a instrução PlotStyle como argumento. Quando não se menciona o PlotStyle ao desenhar algum gráfico, o Mathematica assume certos valores padrões, como a cor roxa em funções de uma variável, uma determinada espessura, etc.

Abaixo um exemplo de como se escreve o comando para se ter uma ideia de como a coisa funciona e algumas de suas opções:


Veja que num único comando Plot agrupei entre chaves três funções diferentes para serem desenhadas ($y=x$, $y=x^2$ e $y=x+1$), e para cada função determinei opções diferentes dentro do PlotStyle. A sintaxe segue a seguinte lógica: PlotStyle -> { {opções da função 1},{opções da função 2},{opções da função 3} }. Para a função 1, $y=x$, escolhi as opções Thick e Orange. Thick faz a linha do gráfico ficar mais grossa e Orange faz a linha ficar laranja. Na segunda função, usei Red para a cor vermelha e Dashed para a linha ficar tracejada. Na última função usei Blue para a cor azul e Thickness[0.03] - o Thickness funciona como o Thick, mas permite que você determine um valor para a espessura da linha a ser desenhada dentro dos colchetes.

Pois bem, entendido como o PlotStyle governa as características de estilo de um gráfico, seguimos adiante para verificar como o Mathematica trabalha com texturas.

Para gráficos gerados por comandos do tipo Plot (Plot, Plot3D, ContourPlot, ParametricPlot, etc.), para inserir uma textura basta adicionar a instrução Texture[nome da textura, variável da textura, etc] como argumento do PlotStyle. No entanto, se você testar este comando para diversos tipos de gráficos e funções, você vai reparar que a textura não se encaixa muito bem ao gráfico, muitas vezes aparece distorcida, etc.
Já gráficos gerados pelos comandos primitivos de Polygon, Rectangle, etc, não aceitam somente Texture[] como instrução (do próprio comando Graphics ou Graphics3D, não do PlotStyle), é preciso de algo mais para que a textura seja aplicada (o comando Disk, por exemplo, nem mesmo admite textura).

Em ambos os casos, a questão por trás dos problemas está ligada ao software não "saber" como posicionar a textura em relação à superfície. É preciso então "dizer" para a linha de comando de que maneira aquela textura deve ser colocada sobre a superfície - e essa maneira está ligada às coordenadas do gráfico. Estudemos alguns exemplos:


Neste exemplo, a textura foi aplicada num polígono. A ordem de cada instrução não é intuitiva, e muitas vezes deve-se recorrer ao help (tecla F1) para entender os detalhes de cada comando. Mesmo assim, vemos que o argumento da instrução Texture foi uma imagem qualquer (você pode, por exemplo dar ctrl+c numa figura da internet e ctrl+v no notebook do Mathematica). O interessante está na capacidade do software aceitar como argumento uma imagem assim, sem mais nem menos. Seguido da textura, o triângulo é definido pelo comando Polygon, cujos argumentos são as coordenadas dos vértices do triângulo. Após determinado as coordenadas do objeto, vamos ter que determinar como a textura vai ser posicionada, e isso é feito, como dito acima, relacionando as próprias coordenadas do triângulo. No caso, as coordenadas utilizadas no comando VertexTextureCoordinates são as mesmas do que o do triângulo, o que indica, a grosso modo, que a sua textura foi "cortada" exatamente no formato do triângulo. Se as coordenadas de entrada do comando VertexTextureCoordinates fossem multiplicadas por 10, por exemplo, então esse triângulo de textura que vemos acima seria repetido diversas vezes dentro do triângulo original.

Utilizando mais imagens e menos texto, veremos como se aplica textura a uma superfície gerada por comandos como o Plot3D, por exemplo:


Em um gráfico 3D, há mais de uma opção para nele fixarmos a textura. A primeira dela é a mais simples, basta prosseguir mais ou menos como no caso anterior, colocando a instrução Texture dentro da PlotStyle. Note entretanto que dessa maneira você não tem controle sobre como a textura é posicionada sobre o gráfico, ou seja, o programa utiliza um padrão interno. Já com o comando TextureCoordinateFunction, é possível determinar de que maneira a textura é colocada em função das variáveis, que são expressas como: #1 = x, #2 = y, #3 = u, #4 = v, sendo que u e v são variáveis paramétricas genéricas (podem ser $r$ e $\theta$ numa parametrização polar, por exemplo). Veja as mudanças que fiz nessas variáveis nos gráficos acima. É possível até colocar valores elevados ao quadrado, também a soma ou subtração, #1+#2, por exemplo. Não entrarei em muitos detalhes pois o post já está extenso, mas se tiver interesse busque modificar os parâmetros por conta e ver os efeitos dessas mudanças - o melhor jeito de aprender é você mesmo manipulando as coisas.

Pois bem, entendido mais ou menos como se coloca textura sobre um gráfico no Mathematica, bastou então pegar uma figura na internet que representasse bem a superfície da batatinha e utilizá-la como textura para o gráfico que encontramos no post anterior.


E está ai a nossa batata Pringles desenhada via equações algébricas e um pouco de malabarismo computacional. Bacana não? Se é verdade que a natureza pode ser descrita através da matemática, imagina toda a trabalheira que isso deve ter dado para o programador universal?

Espero que tenham gostado e aprendido com este post. Com um pouco de criatividade, dá pra se fazer muitas outras coisas com as ferramentas que mostrei. Por exemplo, desenhei a bandeira do Brasil balançando ao vento utilizando texturas enquanto escrevia esta segunda parte:

anim2


No próximo post, vou falar de funções lineares entre espaços vetoriais, as chamadas transformações lineares.


domingo, 10 de julho de 2011

Transformações Lineares de forma qualitativa

Boa noite pessoal,

Há tempos que não escrevo no blog e isto se deve, é claro, ao grande número de tarefas que surgem no fim do semestre acadêmico e outras vicissitudes cotidianas. Não abandonei este espaço - pelo contrário. Tenho na cabeça muitos assuntos (não só de matemática) ainda para escrever, mesmo que devagar. 

Quanto a monitoria, faltaram posts sobre alguns tópicos de álgebra linear, como transformações lineares junto com diagonalização e cônicas. Acredito que esse assunto foi o menos compreendido pelos calouros, uma vez que essa matéria é sempre dada correndo, no fim do semestre, quando se acumulam outros trabalhos de outras disciplinas.

Para entender as transformações lineares, é preciso ter em mente o conceito de função. Uma transformação linear é uma função que atua em vetores e devolve outros vetores. Por ser definida dessa maneira, uma transformação linear não pode depender de base alguma do espaço, no sentido de que a imagem de um vetor sobre uma transformação deve ser a mesma, esteja esse vetor escrito em qualquer base do espaço.

Ora, tome por exemplo a transformação linear, no plano, de rotação anti-horária de 90 graus. Em termos de função, essa transformação linear é uma função que pega o vetor v e devolve o vetor v' que é v rodado de 90 graus. Se o espaço vetorial em questão é descrito pela base A, então o vetor v, na base A, vai se transformar num vetor v', também em A, rodado de 90 graus. Se o vetor v estivesse escrito numa base B e sofresse a transformação, o vetor resultante também seria v', embora suas coordenadas seriam diferentes pois a base B é diferente de A.

Filosofemos sobre o que acabei de dizer: se uma transformação linear tem uma aplicação intrínsica e determinada (girar noventa graus, por exemplo), então basta sabermos como ela atua em uma base qualquer do espaço para saber como ela atua em qualquer vetor do espaço. Nessa afirmação, as duas palavras grifadas não tem o mesmo significado. Perceba que no primeiro caso deve-se eleger uma base - qualquer conjunto de n vetores LI (sendo n a dimensão do espaço). No segundo caso, tendo sido determinada a transformação nessa base elegida e arbitrária, então conhece-se como os infinitos vetores do espaço vetorial mudam quando uma transformação é neles aplicada. Isso ocorre porque se a transformação linear é conhecida na base A, então basta escrever qualquer vetor do espaço em relação a base A.

É possível também se chegar numa maneira de aplicar a transformação em v, na base A, e obter como resposta v' na base B, caso seja conveniente.

A grande dificuldade é se despreender da visão cartesiana. Estamos acostumados a ela, mas há certos casos em que a base canônica não é a mais conveniente para se trabalhar. É ai que entra a tal da diagonalização de operadores e sua aplicação nas cônicas. Na equação das cônicas o termo misto é devido a uma rotação dos eixos normais da curva, de modo que a base de autovetores é a base em que a cônica fica escrita na forma simplificada sem o termo misto.

Talvez a dificuldade maior em tudo isso seja compreender a arbitrariedade presente na teoria de vetores e na álgebra linear como um todo. E isso se adquire com estudo, dedicação e tempo!

Mudando de assunto, neste segundo semestre serei monitor de Física III, que lida com eletrostática e eletromagnetismo clássicos. Portanto, posts sobre física serão mais recorrentes e, assim como fiz em álgebra linear, criarei um espaço dedicado somente aos assuntos da disciplina.


Gostei muito dessa matéria pois aprendi muito. Ver-se-á que o cálculo vetorial é muito bem aplicado nessa teoria, e os teoremas de Gauss e Stokes serão melhores compreendidos nas situações do eletromagnetismo do que foram em Cálculo 2. Embora a teoria eletromagnética clássica tenha sido de certa forma superada (esse não é o termo correto) com o advento da relatividade, da eletrodinâmica quântica, o curso serve como uma boa porta de entrada para a física matemática, física moderna, e também para a ciência contemporânea como um todo, além de ser um bom repositório prático para as situações do dia-a-dia em que lidamos com tomadas, lâmpadas, etc.

Esta será minha quarta monitoria na faculdade, a terceira voluntária. Espero que seja tão frutífera quanto foram as outras, tanto para os alunos quanto para mim.  Falando de outros números, o blog atingiu mais de três mil visitas, em mais de um ano e meio de idade e com 46 posts. Considero um sucesso! Obrigado aos visitantes.

E viva as ferias!

domingo, 27 de março de 2011

Posição Relativa - Retas e Planos

Fiquei um tempo sem postar devido ao retorno às aulas no fim do mês passado, que tomou-me tempo para colocar as coisas em dia. Mas sem mais delongas, hoje vamos falar de um assunto muito interessante, que é a posição relativa entre retas, retas e planos, e planos. 

Esse tópico é passado um tanto quanto rápido nas aulas e não deveria ser assim, pois nele o apelo geométrico aliado ao poder da representação vetorial são notórios e ajudam o estudante a compreender os vetores no espaço e suas relações, sem falar que é um assunto que representa, de fato, o nome da disciplina. O raciocínio e manejos necessários para entendê-lo, quando dominados, demonstram que o estudante compreendeu a teoria com solidez.

Nesse sentido vou tentar mostrar como a visão geométrica e os conceitos da álgebra vetorial nos dão sustentação para resolver os exercícios mais comuns nesse tipo de assunto, sem que precisemos decorar fórmulas. No que segue, vou utilizar os conhecimentos padrões e o fato de que o produto misto entre três vetores é nulo se e somente se os três vetores forem coplanares (I).

Posição relativa entre retas: Lembremos que a reta, na sua representação vetorial ou paramétrica, é escrita da seguinte forma $r:\,X=P_0+t\vec{v}$. No espaço $\mathbb{R}^3$, essa equação se desdobra em três: $(x,y,z)=(x_0,y_0,z_0)+t\{v_x,v_y,v_z\}$, uma para cada coordenada. O ponto $P_0$ é um ponto qualquer, e $\vec{v}$ é o vetor diretor da reta.

Então consideremos duas retas no $\mathbb{R}^3$, $r_1$ e $r_2$, com vetores diretores $\vec{v}_1$ e $\vec{v}_2$. Há três casos a se considerar:
  1. $r_1$ e $r_2$ são paralelas (podem ou não ser coincidentes).
  2. $r_1$ e $r_2$ são concorrentes.
  3. $r_1$ e $r_2$ são reversas.
Vejamos qual a implicação, em termos vetoriais, de cada caso:
  1. Se $r_1$ e $r_2$ são paralelas então há três fatos a se considerar:
    • Os vetores diretores $\vec{v}_1$ e $\vec{v}_2$ também são paralelos. Isso implica que $\vec{v}_1$ e $\vec{v}_2$ são proporcionais, isto é, existe algum escalar $k\in\mathbb{R}$ tal que $\vec{v}_1=k\cdot\vec{v}_2$ (lembre-se que os vetores são livres, e por isso a proporcionalidade não requer colinearidade). 
    • Além disso, por serem paralelas, as retas $r_1$ e $r_2$ estão contidas num mesmo plano $\pi$, de modo que se tomarmos o segmento $\overline{P_2P_1}$, sendo $P_1\in r_1$ e $P_2\in r_2$, ele deve estar em $\pi$ assim como estão $\vec{v}_1$ e $\vec{v}_2$ . A condição que expressa coplanaridade entre vetores é (I), ou seja $(\vec{v}_1\times\vec{v}_2)\cdot\overline{P_1P_2}=0$. Repare na cadeia lógica de fatos: o produto misto é dado pelo determinante da matriz composta pelos vetores diretores da reta e um vetor fabricado que mora entre essas retas paralelas. Como os vetores diretores das retas são paralelos, isso implica que um é múltiplo do outro, o que implica numa linha ser múltipla da outra na matriz do produto misto, que implica no determinante ser zero. 
    • As retas podem ou não ser coincidentes. Deixo para o leitor verificar quais são as condições que asseguram a coincidência das retas.
  2. Se $r_1$ e $r_2$ são concorrentes, então há três fatos a se considerar:
    • Os vetores diretores $\vec{v}_1$ e $\vec{v}_2$ não são paralelos e portanto não proporcionais, de modo que é impossível encontrar $k\in\mathbb{R}$ que verifique $\vec{v}_1=k\cdot\vec{v}_2$.
    • A intersecção $r_1 \cap r_2 = \{P\}$ é um ponto que pode ser determinado igualando-se as coordenadas das duas retas e resolvendo o sistema resultante.
    • Se tomarmos, assim como no caso anterior, um segmento que liga as duas retas, $\overline{P_2P_1}$, sendo $P_1\in r_1$ e $P_2\in r_2$, ele também estará contido num plano suporte (que contém) de $r_1$ e $r_2$. Por consequência, o produto misto $(\vec{v}_1\times\vec{v}_2)\cdot\overline{P_1P_2}$ também se anula. Novamente, verifique que uma das linhas da matriz do produto misto é combinação linear das outras, o que implica na nulidade do determinante e do produto misto.
  3. Se você verificou que as condições 1 e 2 não se aplicam ao caso que você estuda, então por exclusão as retas são reversas. Logicamente, o argumento é válido. Na prática, é pouco utilizado, uma vez que existem métodos, como os anteriores, para determinar essa característica entre duas retas. Então se $r_1$ e $r_2$ são reversas:
    • Os vetores diretores $\vec{v}_1$ e $\vec{v}_2$ não são paralelos e portanto não proporcionais, de modo que é impossível encontrar $k\in\mathbb{R}$ que verifique $\vec{v}_1=k\cdot\vec{v}_2$.
    •  A intersecção $r_1 \cap r_2 = \{O\}$. Além disso, as próprias retas estão contidas em planos diferentes.
    • Neste caso, ao fabricarmos um segmento $\overline{P_2P_1}$, sendo $P_1\in r_1$ e $P_2\in r_2$, não haverá coplanaridade, de modo que o produto misto $(\vec{v}_1\times\vec{v}_2)\cdot\overline{P_1P_2}\neq0$.
Repare então que as condições são algebricamente elaboradas, mas simples pois há a visualização geométrica do fato estudado:

Retas paralelas, a construção do plano suporte e do segmento entre as duas retas
Retas concorrentes, a construção do plano suporte, o segmento entre as retas e os vetores diretores das retas.

Retas reversas, os planos suportes de cada reta, o segmento entre as retas (que está em outro plano) e os vetores diretores das retas e do segmento. Com um pouco de boa vontade vc verá que o produto misto desses vetores não é nulo.

Posição relativa entre planos: Seja $\pi_1$ e $\pi_2$ dois planos no espaço e $\vec{n}_1$ e $\vec{n}_2$ os vetores normais aos respectivos planos. É possível ocorrer:

  1. $\pi_1$ e $\pi_2$ são paralelos (podem ou não ser coincidentes).
  2. $\pi_1$ e $\pi_2$ são concorrentes.
 Se o leitor compreendeu a ideia da análise da posição relativa de retas por meio de seus vetores diretores, então determinar a posição relativa de planos torna-se fácil pois basta verificar a relação entre os vetores normais:
  1. Se $\vec{n}_1$ e $\vec{n}_2$ forem paralelos os planos também o serão. Se são paralelos, então são proporcionais - assim existe um $k\in\mathbb{R}$ que verifica a relação $\vec{n}_1=k\cdot \vec{n}_2$.
  2. Se $\vec{n}_1$ e $\vec{n}_2$ não forem paralelos, então os planos são concorrentes.
Posição relativa entre reta e plano: Com base nos casos anteriores, tente verificar algumas possibilidades por si mesmo. No próximo post discuto essas posições relativas, bem como entro na questão de distância entre pontos, etc.

Abraços!

segunda-feira, 7 de fevereiro de 2011

Sobre sistemas lineares.

Esse post vai falar rapidamente sobre sistemas lineares - sem escrever as matrizes dos sistemas, pois isso cansa pra fazer aqui. A ideia é fazer algo mais qualitativo - espera-se que o leitor tenha um conhecimento básico em matrizes e operações elementares (matriz linha reduzida - escada).

Bem, um sistema linear é uma expressão da forma $Ax=b$, onde $A$ é uma matriz de ordem $m\,x\,n$ conhecida, $x$ é um vetor coluna  $n\,x\,1$ desconhecido (queremos encontrá-lo) e $b$ é o chamado vetor de dados $m\,x\,1$.
Para não haver confusão, dizer que se $A$ é $m\,x\,n$ significa que a matriz tem $m$ linhas e $n$ colunas. Em outras palavras, o sistema $Ax=b$ tem $m$ equações e $n$ incógnitas.

No que se refere a solução deste sistema, consideremos o caso em que $m = n$ e $b\neq 0$ .  Isso quer dizer que $A$ é uma matriz quadrada e que o sistema é não-homogêneo.

No caso de $A$ ter inversa, $A^{-1}$, a solução do sistema $Ax=b$ é obtida multiplicando-se os dois lados pela inversa (respeitando a ordem da multiplicação). Ou seja: $A^{-1}Ax=A^{-1}b \Rightarrow x=A^{-1}b$ pois $A^{-1}A=I$.
Veja que o sistema $Ax=b$ tem solução se e somente se $A$ for inversível, e uma condição para que $A$ seja inversível é que $det A\neq 0$.

Isso nos leva a outra situação. Se $det A=0$ a matriz $A$ não tem inversa - o que nos leva a considerar alguns casos menos diretos que o anterior - quando o sistema pode ou não ter solução.

Quando não há solução: Imagine o sistema formado pelas equações $x + y = 1$ e $2x + 2y = 3$. Notadamente, vemos que o sistema não tem solução pois a segunda equação soma as quantidades x e y em dobro mas o resultado é 3 e não 2, pela primeira equação. Como verificamos esse fato na forma matricial?

Bem, considere duas matrizes $A$ e $A_e$. $A$ é a matriz dos coeficientes, a qual estávamos nos referindo anteriormente, e $A_e$ é a chamada matriz estendida do sistema - essa matriz difere de $A$ pois existe uma coluna a mais, e essa coluna recebe os valores do vetor de dados $b$. Isto é, $A_e = [A|b]$. Se realizarmos operações linha nessas duas matrizes para colocá-las na forma escada, vamos chegar na situação em que a forma escada de $A$ contém uma linha cheia de zeros e a forma escada de $A_e$ não - voltando a pensar no sistema de equações, chegamos num absurdo onde $0x+0y=1$ - Como detectamos esse absurdo operando nas matrizes dos sistemas?

Chamamos de posto de uma matriz o número de linhas não-nulas na sua forma escada. Então o posto de $A$ (na forma escada) é $1$, e o posto de $A_e$ (na forma escada) é $2$. Quando o posto de $A$ é diferente do posto de $A_e$, então o sistema é impossível. Isso é um teorema, demonstrado mais ou menos por essas ideias que comentamos.

Quando há solução: Mudando um pouco o exemplo anterior, o sistema formado por $x + y = 1$ e $2x + 2y = 2$ é "verdadeiro" no sentido da segunda equação ser o dobro da primeira. Isso quer dizer que tomando qualquer par de números (x,y) que satisfaça a primeira equação, a segunda também o será e vice-versa. Pensando em matrizes, quando o posto de $A$ for igual ao posto de $A_e$, (ambas em sua forma escada),  o sistema $Ax=b$ admite infinitas soluções. (verifique!)

Vimos até agora rapidamente que as soluções de um sistema linear dependem da matriz do sistema ter ou não determinante nulo. Agora vamos abordar o caso do sistema $Ax=0$, isto é, com $b=0$ (e $m=n$). Esse sistema é chamado sistema linear homogêneo.

Da mesma maneira, vamos verificar o que acontece com as soluções à partir do determinante:

Se $detA\neq 0$ a coisa não muda - a matriz $A$ tem inversa e a solução do sistema é dada por $x=A^{-1}0 = 0$. Opa. $x = 0$. Essa é a famosa solução trivial. Na prática, é raro querermos as soluções triviais de um sistema.

Mas se $detA=0$, a matriz $A$ não possuí inversa. Assim, devemos analisar o posto de $A$ e o posto de $A_e$ na forma escada para verificar se o sistema possuí ou não solução. Mas não precisamos de fato analisar o posto pelo seguinte motivo:

A expressão $det A=0$ siginifica que uma linha de $A$ é combinação linear das linhas de $A$. Quando aplicarmos as operações elementares para reduzir $A$ para sua forma escada, essa linha, combinação das outras, vai se anular. Como o vetor de dados é também nulo, o posto de $A_e$ não será modificado e teremos posto de $A$ igual ao posto de $A_e$. Logo, o sistema possuirá infinitas soluções.

Em outros ramos da matemática (e muitas vezes da física), quando chegamos num sistema homogêneo buscamos sempre as soluções não triviais. Assim, para haver soluções não trivias impômos ao determinante da matriz do sistema ser nulo, com base nas ideias discutidas acima.

Talvez o leitor se pergunte - por que tanta algebrização, definição, etc etc etc. Bem, a simplicidade de um sistema 2x2 é traiçoeira, de modo que não podemos supor sua existência nos sistemas de ordens maiores. Ao trabalhar com sistemas, 20x20, 50x50, 1000x1000, essa sistematização é inevitável para encontrar soluções, etc.

Talvez eu tenha esquecido de algo, pois escrevi isso bem rápido. Esse tema tem muito pano para a manga, e quando falarmos de espaços vetoriais, subespaços, as coisas ficarão mais interessantes.

Abraços. Parabéns aos alunos que foram aprovados no vestibular (o resultado saiu hoje).

sábado, 29 de janeiro de 2011

Parametrização de retas


Esse post é continuação para suplemento de geometria analítica. No anterior em suma falamos de vetores, algumas operações básicas e propriedades. Depois insistimos na ideia de vetores como transportadores de pontos.

Eu havia escrito uma outra coisa sobre vetores para colocar aqui, mas não me agradou, então pensei em redigir algumas notas que provavelmente eu gostaria de ter lido quando estudei essa disciplina, há 2 anos atrás. Novamente, deixo de lado o rigor para evocar o lado intuitivo do assunto.

Então nesse sentido de pequenas notas, acho legal esclarecer alguns conceitos que a primeira vista nos parecem dúbios.

1- Estando num sistema de eixos cartesianos, representamos um ponto como uma dupla de números: Por exemplo, o ponto $P=(1,2)$. Cada número da dupla recebe o nome de coordenada do ponto.

2- Um vetor também é representado por uma dupla de números (cada um chamado de componente do vetor), por exemplo $\vec{v}=<-2,1>$. Porém, ele não indica um ponto no plano, mas sim um deslocamento (neste caso em linha reta), sendo que cada componente do vetor indica a variação que ele causa na coordenada correspondente do ponto sobre o qual ele atua.


3- Ou seja, um vetor não tem lugar fixo no plano (isso é muito importante) – no fundo ele transporta, desloca pontos numa determinada direção e na intensidade correspondente às suas coordenadas quando aplicamos ele sobre um ponto. O que vemos na figura acima são os deslocamentos causados pelo vetor $\vec{v}=<-2,1>$ em diferentes pontos do plano. Isto é: O vetor $\vec{v}=<-2,1>$, aplicado ao ponto $(1,2)$ leva-o até o $(-1,3)$.


Reta paramétrica:

Quando queremos determinar uma reta, é necessário e suficiente:

  • conhecer dois pontos por onde ela passa

Vou deixar de lado o termo “equação” da reta, pois ele ainda traz a ideia cartesiana do negócio ($y=ax+b$). Ao invés disso, falaremos da descrição vetorial da reta, ou, mais simplificadamente, da parametrização da reta.

A ideia é simples. Imagine um ponto. Imagine uma direção (pense na rosa dos ventos assentada sobre esse ponto). Imagine o ponto deslocando-se numa determinada direção em linha reta e deixando um rastro no chão. Voilá, você obteve uma reta.

Agora como descreveremos isso em termos matemáticos? Há duas maneiras, uma mais intuitiva, menos rigorosa. Outro nem tanto intuitiva (no primeiro momento), mas mais fundamental. Vou descrever a última, enquanto que a primeira deixo para conversar nos atendimentos extra classe.

a) a descrição formal é a seguinte: suponha que tenhamos uma reta $r$, no $\mathbb{R}^3$ que não sabemos a equação, mas sabemos que ela passa pelo ponto $P_0=(a,b,c)$ e é paralela ao vetor $\vec{d}=(d_1,d_2,d_3)$. Seja $P=(x,y,z)$ um ponto qualquer dessa reta. Se $P$ pertence a reta, então o vetor $P-P_0=(x-a,y-b,z-c)$ deve ser paralelo ao vetor $\vec{d}=(d_1,d_2,d_3)$.

A condição para que dois vetores sejam paralelos diz que um deve ser múltiplo do outro. Isto é:
$P-P_0=t \vec{d}$, onde $t$ é o múltiplo escalar $\in\mathbb{R}$. Como o ponto $P$ é arbitrário, chegamos na descrição paramétrica da reta: $P = P_0 + t\vec{d}$. 

Repare que a equação faz sentido e bate com a descrição que dei acima de um ponto sendo deslocado numa direção. Nesse caso, o fator $t$ determina qual a quantidade de incrementos na direção de $d$ o ponto $P_0$ sofrerá.

O vetor $\vec{d}$ é chamado de vetor diretor da reta. É importante notar que não é necessário que o vetor esteja sobre a reta – isso no fundo não faz nem sentido. O vetor tem que dar a direção, e por isso argumentamos no sentido dele ser paralelo à reta.

Veja que a forma $P = P_0 + t\vec{d}$  é muito similar à equação de movimento uniforme da física, $S = S_0 + vt$. Repare que essa equação é escalar, pois o movimento é unidimensional - mas definindo a reta de forma paramétrica, avançamos um passo na descrição de movimentos pois nos livramos da análise numa direção só. Com o tratamento vetorial é possível representar deslocamentos um mais gerais.

Outras observações: É importante ressaltar alguns fatos que às vezes não se comenta na sala de aula. Um deles diz respeito a existência de infinitas parametrizações. Isto é, sempre que for possível parametrizar um segmento qualquer, uma superfície, um objeto, tenha em mente que existem infinitas parametrizações - então não fique frustrado se seu resultado não bateu com o do gabarito.
Uma prova fraca: Para definiar a reta utilizamos um ponto e um vetor diretor. Não dei importância para o tamanho desse vetor, mas sim somente em sua direção. Isso quer dizer que a reta fica bem definida (no sentido da parametrização) tendo um ponto e qualquer vetor que tenha a direção pré-fixada. Como existem infinitos vetores paralelos a um vetor dado, segue que existem infinitas parametrizações de retas.

Bem, acho que isso é tudo de "dicas" que tenho nas mangas. Nos próximo post, falarei dos planos e suas parametrizações.


Ah, também falarei um pouco da importância das parametrizações para representação de superfícies mais gerais, e seu consequente uso no cálculo integral.

E não me esqueci do Taylor em 2 variáveis... hehe.

terça-feira, 28 de dezembro de 2010

Revisão básica de vetores

Como serei monitor da turma de 2011 de Geometria Analítica e Álgebra Linear da FCA, começo nesse fim de dezembro a escrever, sem muito rigor, sobre tópicos da matéria. Faço isso por dois motivos. Primeiro, o rigor em excesso no início pode ser prejudicial e até afugentador, por isso, um texto informal ajuda na compreensão geral do assunto. Segundo, pretendo melhorar o blog como ferramenta de auxilio da monitoria, assim, preciso seguir minimamente os tópicos da ementa e assim farei de modo descontraído, pois os formalismos estão nos livros.

Se o início da disciplina não for feito em cima de matrizes e sistemas lineares, então possívelmente será feito sobre vetores.

Nosso primeiro contato com vetores acontece geralmente no ensino médio, e é feito de maneira a familiarizar o aluno com as operações básicas. Uma breve retrospectiva:

(1) Define-se vetor como sendo um segmento de reta orientado, mas essa não é uma definição interessante e veremos o por quê mais adiante.

(2) Representamos algebricamente os vetores no plano como sendo duplas de números. Se os vetores partem da origem, então a dupla $(x,y)$ representa o "segmento de reta" que sai origem e chega até o ponto $(x,y)$. Mais geral, dado um ponto inicial $P_0=(a,b)$ e um ponto final $P=(c,d)$, temos $\vec{P_0P}=(c-a,d-b)$ o vetor que liga $P_0$ a $P$.


(3) A soma vetorial é feita componente a componente. Se $\vec{v_1}=(x_1,y_1)$ e $\vec{v_2}=(x_2,y_2)$ são vetores, então a soma fica $\vec{v_1}+\vec{v_2}=(x_1+x_2,y_1+y_2)$. A subtração é vista como a soma de vetores, mas o vetor que subtraí fica com o sinal contrário:

$\vec{v_1}-\vec{v_2}=\vec{v_1}+(-\vec{v_2})=(x_1-x_2,y_1-y_2)$.

Os vetores obedecem aos axiomas de espaço vetoriais, coisa que podemos falar mais adiante. Basicamente, a soma é comutativa e associativa, existe inverso aditivo, elementro neutro da adição, e etc etc etc...

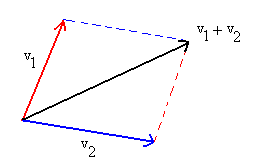
(4) Graficamente, a soma vetorial é feita pela regra do paralelogramo.


(5) Muitas vezes precisamos determinar o tamanho do vetor. A visualização gráfica do vetor no plano sugere naturalmente que o comprimento do vetor venha do teorema de Pitágoras. Ou seja, chamamos de módulo de $\vec{v}$, $||\vec{v}||$, o comprimento do vetor v, cuja expressão é $||\vec{v}||=\sqrt{x_1^2+y_1^2}$.

(6) Não existe "divisão" vetorial, mas existe multiplicação de um vetor por um escalar: $k\vec{v}=k(x_1,y_1)=(kx_1,ky_1)$ com $k\in\mathbb{R}$. Se $k=\dfrac{1}{||\vec{v}||}$, então $k\vec{v}=\dfrac{\vec{v}}{||\vec{v}||}=\vec{u}$ e dizemos que u é vetor unitário. O que acabamos de fazer foi dividir cada componente de $\vec{v}=(x_1,y_1)$ pelo tamanho do vetor, assim, geramos um novo vetor $\vec{u}$, cuja direção é a mesma de $\vec{v}$, mas seu comprimento é menor que o original e tem tamanho 1.

(7) O produto escalar (ou produto interno) é uma operação entre dois vetores que a eles associa um número, Normalmente se $\vec{v_1}=(x_1,y_1)$ e $\vec{v_2}=(x_2,y_2)$, então $\vec{v_1}\cdot\vec{v_2}=x_1x_2+y_1y_2$. Digo normalmente pois existem outros tipos de produtos internos, mas isso falaremos depois.
O produto vetorial é outro tipo de operação entre dois vetores e que a eles associa um novo vetor, ortogonal aos dois primeiros. Dedicarei um post especial para estudar o produto escalar e o vetorial, explicar algumas propriedades e principalmente aplicações na física.

Bem, se os vetores são os mesmos que estudamos no colégio, qual a diferença para os vetores de agora?

(i) Os vetores agora são fundamentados dentro de um assunto maior, que é a álgebra linear. A álgebra linear se ocupa basicamente das transformações lineares, que podem ser vistas como funções entre espaços vetoriais. Essas coisas farão mais sentido no futuro, quando as estudaremos mais a fundo, etc. Uma aplicação dos conceitos está, por exemplo, nos sistemas lineares $Ax=b$, quando dizemos que é necessário e suficiente que b pertença à imagem da transformação linear A para que exista solução.

(ii) Na realidade, a álgebra linear é uma disciplina separada da geometria analítica, mas num curso introdutório é interessante associá-las pois a geometria ajuda a entender os conceitos da álgebra, assim como a álgebra vetorial vai facilitar muito alguns problemas de geometria.

(iii) Uma outra coisa muito interessante que a álgebra linear permite é generalizar o conceito de dimensão. No plano, um vetor é dado por uma dupla de números. No espaço, uma tripla. Em 4 dimensões, são necessários 4 números, ou uma quádrupla, para determinar o vetor, e assim seguem as outras definições (de produto interno, módulo, etc). Isso não significa que essas dimensões existam fisicamente, mas elas fazem sentido matematicamente.

(iv) A palavra vetor vem do latim vector - aquele que transporta alguma coisa. O significado etimológico não se relaciona com a definição de "segmento de reta orientado", porém, é mais intuitivo pensar em vetores como transportadores de pontos, como a definição da palavra sugere. Mas como assim?

Bem, imagine um mapa cartográfico - vamos pegar dois pontos nesses mapa, $P_0=(x_1,y_1)$ e $P=(x_2,y_2)$. Suponha que estejamos dentro de um carro em $P_0$ e nosso destino é chegar em $P$. Sabemos, como eu expliquei acima, que um vetor age sobre os pontos, transportando-os. Vamos empregar esta idéia em nossa situação: O vetor que liga $P_0$ a $P$ é dado por $\overline{P_0P}=P-P_0=(x_2-x_1,y_2-y_1)$. Se somármos esse vetor com o nosso ponto inicial, $\overline{P_0P} + P_0$, vamos obter: $(x_2-x_1+x_1,y_2-y_1+y_1) = (x_2,y_2) = P$, uma vez que $\overline{P_0P} + P_0=P-P_0+P_0=P$ ou seja, bastaria nos deslocarmos $||\overline{P_0P}||$ unidades de comprimento na direção de $\overline{P_0P}$ para que chegássemos ao ponto $P$. Então repare que de fato os vetores representam deslocamentos de um ponto até outro quando efetuamos essa soma.


Ano que vem começo a falar da parametrização de reta e de outras coisas, utilizando a ideia acima. Também estou devendo um post sobre Taylor em duas variáveis, o que farei provavelmente em fevereiro. Abraços!


sábado, 9 de outubro de 2010

Máximos e mínimos com multiplicadores de Lagrange

CONFIRA O NOVO POST SOBRE MULTIPLICADOR DE LAGRANGE AQUI: Máximos e mínimos com multiplicadores de Lagrange 2

Diferentemente dos métodos empregados no cálculo de uma variável, encontrar os máximos e mínimos de uma função de duas ou mais variáveis pode ser às vezes penoso por conta da análise que deve ser feita: Se $f(x,y)$  é uma função definida numa região R compacta, é preciso investigar se os máximos e mínimos estão no interior de R ou se estão na propria fronteira de R. 
Geralmente, o que se tem é uma função de três variáveis $f(x,y,z)$, sujeita a qualquer condição restritiva que nos permita eliminar uma variável do problema. Daí ficamos com uma função de duas variáveis, então procuramos os máx. e mins. pelos os métodos usuais - no interior de R, derivamos e impomos as derivadas pariciais serem zero para encontrar os pontos críticos, candidatos a máximos e mínimos. Depois, analisamos, usualmente através da parametrização, a curva que descreve o contorno da fronteira.
Como esse processo pode ser muito complicado se as funções forem complicadas, se a borda da região for díficil de parametrizar, etc, uma boa e eficente saída é utilizar o método dos multiplicadores de Lagrange.
O método dos multiplicadores no caso bidimensional fala que, se nosso objetivo é maximizar uma função $f(x,y)$ sujeito à restrição $g(x,y)=c$, os extremos de $f$ em $g$ ocorrem nos pontos em que se verifica a relação:
$\nabla f = \lambda \nabla g$

Lógico que a eq. acima tem sentido somente se as derivadas parciais de primeira ordem de $f$ e $g$ existirem e $\nabla g$ não se anular na curva vinculante. Geometricamente, essa equação vetorial nos diz que o gradiente da função a ser maximizada é proporcional ao gradiente da função vinculante (*). Isso faz sentido, porque, imagine que queremos maximizar uma função $f(x,y)$ sujeita a uma curva parametrizada por $u(t)=(x(t),y(t))$. Assim, caímos num problema de maximização de cálculo I pois $f(x(t),y(t))$ é função de uma variável. Então temos:
$\dfrac{d}{dt}f(x(t),y(t)) = 0$
pela regra da cadeia:
$\dfrac{df}{dx}\dfrac{dx(t)}{dt}+\dfrac{df}{dy}\dfrac{dy(t)}{dt} =0 \Rightarrow \nabla f\cdot u`(t) = 0$
 O que quer dizer que o gradiente da f é ortogonal ao vetor tangente da curva - uma outra forma de dizer (*).

Agora quando buscamos maximizar uma função de três variáveis $f(x,y,z)$ sujeita aos vínculos $g(x,y,z)=c$ e $h(x,y,z)=k$, escrevemos:
$\nabla f = \lambda\nabla g + \mu\nabla h$
que nos leva a um sistema de 5 equações e 5 incógnitas:
$f_x = \lambda g_x + \mu h_x$
$f_y = \lambda g_y + \mu h_y$
$f_z = \lambda g_z + \mu h_z$
$g(x,y,z)=c$
$h(x,y,z)=k$
O subscrito denota a derivada parcial. Resolver esse sistema não-linear é um tanto quanto chato na maioria das vezes, mas é resolvível. Ocorre que podemos desenvolver uma ideia geométrica análoga ao que fizemos para o caso de duas variáveis e simplificar sua solução. Tomemos a figura abaixo

Essa é nossa situação em Lagrange com doís vínculos. Obtemos uma curva formada pela intersecção das duas superfícies vinculantes e queremos maximizar a função $f$ sujeita a esta curva. Os gradientes de cada restrição formam um plano, e o método dos multiplicadores exige que o gradiente da função a ser maximizada more neste plano. Esse resultado vai de encontro com o análogo bidimensional, quando o gradiente da função era proporcional ao gradiente da restrição ou ortogonal ao vetor tangente da curva restritiva (são as mesmas condições). Assim, é possível utilizar um resultado da geometria analítica para eliminar os multiplicadores de forma que se resolva somente um sistema 3x3. Vejamos como:

A condição para que três vetores sejam coplanares é que o produto misto entre eles seja zero. Faz sentido, pois o produto misto envolve um produto vetorial que no caso 3x3 é um determinante e como bem sabemos o determinante se anula quando existe uma linha proporcional as outras - este é nosso caso, pois queremos que $\nabla f = \lambda\nabla g + \mu\nabla h$. Então tudo se resume em realizar o produto misto $\nabla f\cdot (\nabla g \times\nabla h)$ e igualá-lo a zero.

E assim chegamos a uma equação equivalente a equação dos multiplicadores de Lagrange porém sem os multiplicadores. Esse resultado é interessante e simplifica muito o trabalho de se resolver maximos e mínimos condicionados, porém torna-se inviável utilizá-lo quando a função possuí  n variáveis (n>3) e exige que existam n-1 condições vinculantes. Mesmo assim, é uma ferramenta útil - verifique em exercícios já resolvidos pelo método usual.
No próximo post resolveremos um exercício por este método e verificaremos de fato que simplifica as contas. Abraços.
Os créditos da figura são do prof. Márcio Rosa.


Postagem em destaque

Quais os melhores livros de Cálculo 1?

Uma dúvida muito comum de quem acabou de entrar na faculdade de exatas é qual livro de cálculo seguir e adotar como referência. Consulta...